
이직 첫날이었어요. 클론받은 레포를 여니까 폴더가 스크롤 세 번을 넘겨도 안 끝나더라고요. main 하나 찾겠다고 뒤지다 진입점만 스무 개를 발견했습니다.
6년차인데도 그 앞에선 신입처럼 커서만 깜빡였네요. 그때 깨달은 게 하나 있어요. 전부 이해하고 손대려던 게 함정이었습니다. 지도는 다 읽어서가 아니라 걸어다니면서 그려지더라고요.
처음 보는 코드베이스, 다 읽으려다 3주째 헤매던 이유
일단 통계 하나 짚고 갈게요. 개발자가 근무시간의 절반을 훌쩍 넘게 남의 코드를 읽는 데 쓴다고 합니다. 자료마다 편차는 있는데 대략 58~70% 수준으로 보고돼요. 로버트 마틴의 『Clean Code』에서는 읽기 대 쓰기 비율이 10:1을 넘는다고 하고요, 레거시에선 이게 더 벌어집니다.
10:1이 어느 정도냐면, 한 줄 새로 짜려고 기존 코드 열 줄을 먼저 읽고 이해해야 한다는 뜻이에요. 코딩이 곧 타이핑이라는 감각부터 틀렸던 거죠.
여기서 위로가 되는 사실이 하나 있습니다. 대형 코드베이스에서 제 몫을 하기까지 보통 6개월, 규모 큰 회사면 1년 넘게 걸린다는 얘기가 많아요. 그러니까 입사 3주째 헤매는 건 실력 저하가 아니라 그냥 통계적으로 정상 구간입니다. 완전한 이해는 출발선이 아니라, 손대면서 뒤따라오는 결과였던 거예요.
레거시 코드 분석은 진입점 목록부터 시작합니다
레거시를 "오래되고 더러운 코드"라고 생각하기 쉬운데요. 마이클 페더스는 좀 다르게 정의합니다. 테스트로 보호되지 않아서 안전하게 바꿀 수 없는 코드가 레거시라는 겁니다. 이 기준대로면 어제 머지된 커밋도 이미 레거시일 수 있어요.
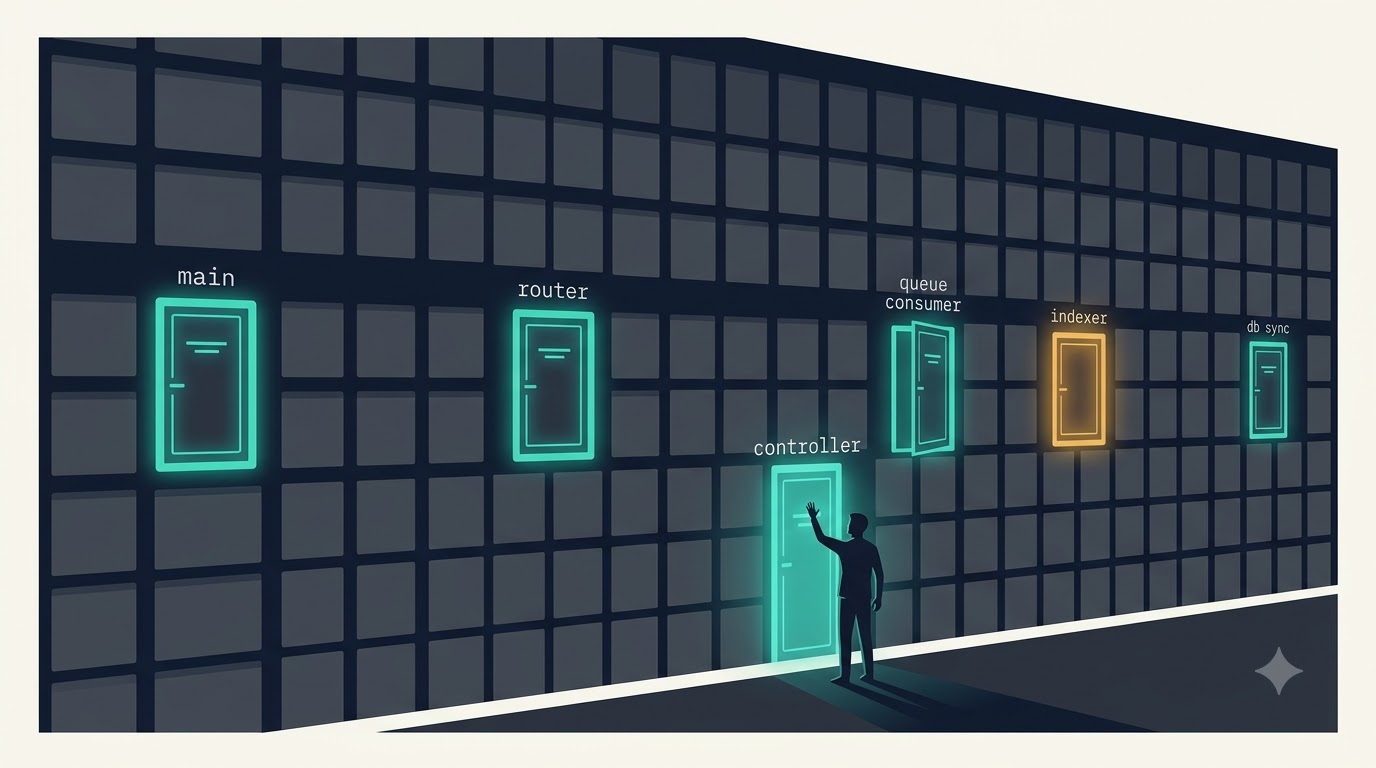
두려움의 정체가 코드 나이가 아니라 "바꿨을 때 결과가 예측이 안 되는 상태"라는 뜻이에요. 그래서 첫 목표를 "이해"가 아니라 "시스템의 문 찾기"로 바꾸는 게 낫다고 봅니다.
문이 바로 진입점이에요. main, 라우터, 컨트롤러, 큐 컨슈머 같은 것들이요. 이것부터 목록으로 만들면 거대한 폴더 트리가 몇 개의 입구로 압축됩니다. 여기서 정적으로 파일만 뒤지지 말고, IDE의 Call Hierarchy나 Find Usages로 호출·의존 그래프를 띄우는 게 훨씬 빨라요.
다만 진입점 위치는 도메인마다 완전히 달라집니다. SPA, 모놀리식, 임베디드, 데이터 파이프라인이 다 제각각이라 단일 정답은 없어요. 제가 주로 하는 안드로이드라면 매니페스트에 선언된 Activity·Fragment, 그리고 딥링크 진입이 사실상 "문" 역할을 하는 셈이에요.
데이터 흐름 추적으로 기능 하나를 세로로 관통하기
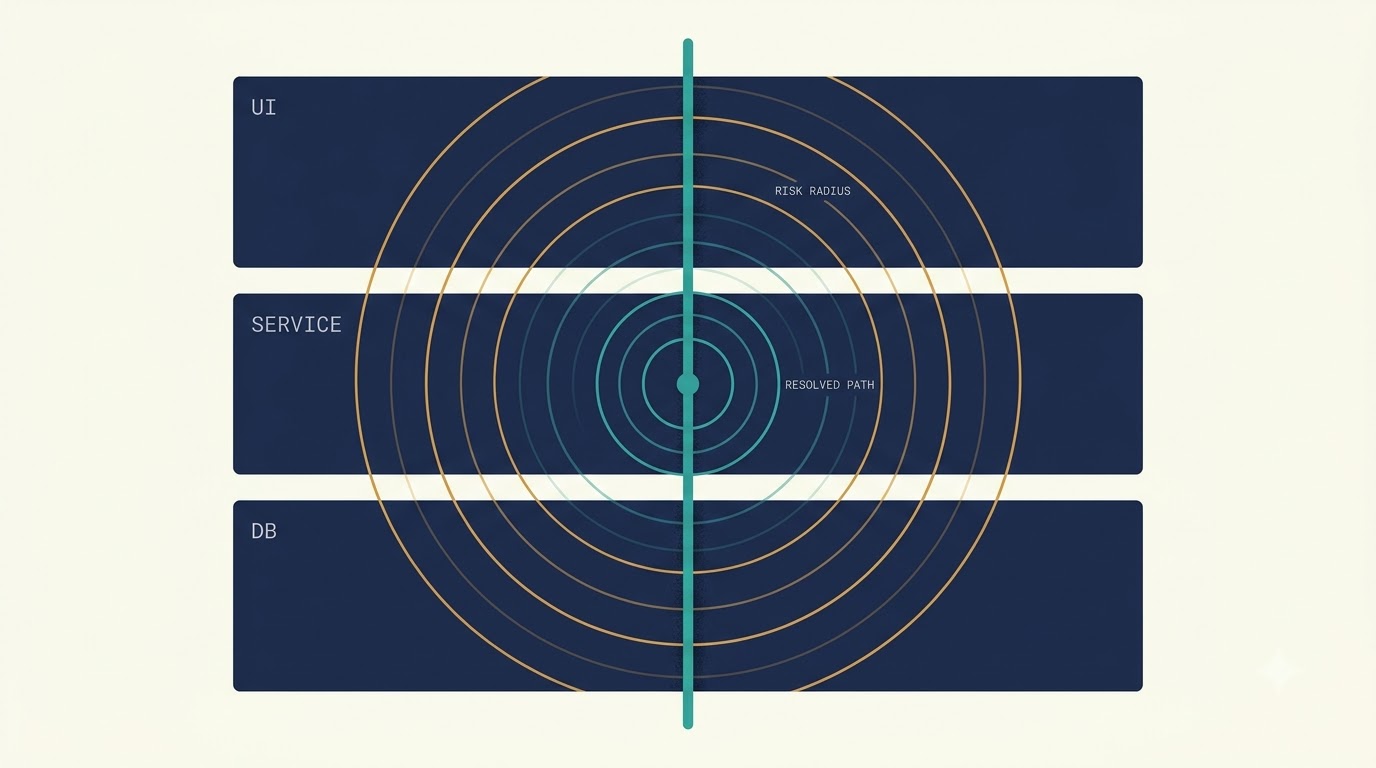
진입점을 잡았으면 전체를 위에서 아래로 훑으려는 유혹을 눌러야 합니다. 그러다간 영원히 못 끝내요. 대신 다음 주에 제가 건드릴 기능 딱 하나를 골라서 세로로 관통합니다.
UI 입력 → 서비스 로직 → DB 저장까지, 한 줄기만 끝까지 따라가는 거예요. 저는 이걸 "위험도 축 동심원 읽기"라고 부릅니다. 시간순으로 다 읽는 게 아니라, 내가 곧 손댈 반경부터 바깥으로 넓혀가는 방식이죠.
이때 눈으로만 읽지 마시고 실행을 시키셔야 해요. 함수 호출을 기원까지 역추적하면서 입력·출력·에러 경로를 확인하는데, 브레이크포인트 하나 걸고 실제 요청을 한 번 흘려보내는 게 30분 정독보다 빠를 때가 많습니다. 스택 트레이스가 읽기 순서를 대신 그려주거든요.
물론 반론도 있어요. 환경이 복잡하거나 실행 비용이 크거나, 실데이터가 민감해서 못 돌리는 경우도 생깁니다. 그럴 땐 정적 독해가 유일한 수단이 되는 거죠. 그래서 "무조건 실행"이 아니라 "가능하면 실행 우선"이 정확한 표현입니다.
손으로 지도 그리고 Git 히스토리로 이유 캐기
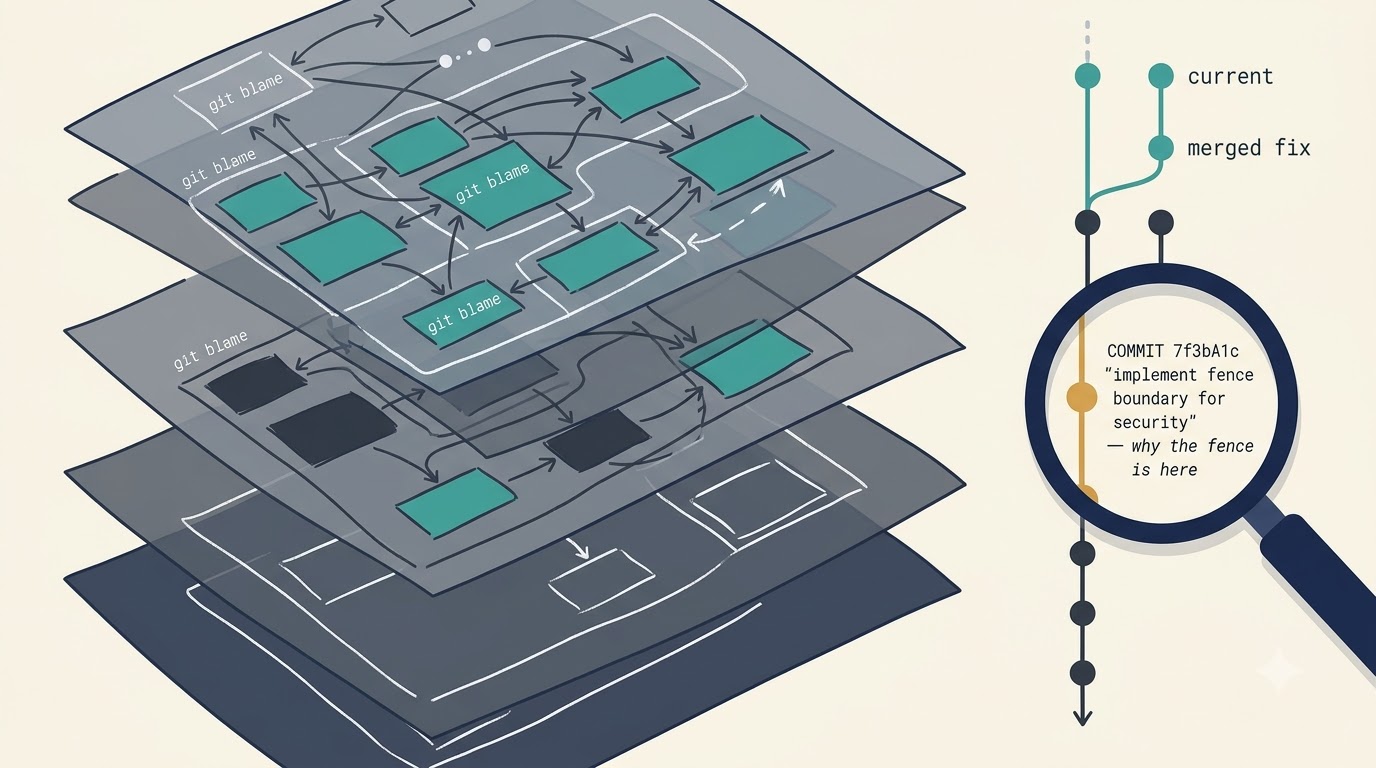
따라간 흐름은 종이나 화이트보드에 손으로 옮겨 그리는 걸 추천드리고 싶네요. 모듈, 경계, 데이터가 흐르는 방향을 대충이라도요. 한 번에 완성되진 않습니다. 작은 변경을 반복하다 보면 지도가 여러 겹으로 쌓입니다.
그리고 "왜 이 코드가 이렇게 생겼나" 싶은 자리가 나오면 git blame과 커밋 히스토리를 봅니다. 관련 PR과 이슈까지 타고 올라가면, 더러워 보이던 코드가 사실 당시 제약 속에서 나름 합리적인 결정이었던 경우를 자주 만나요. 울타리가 왜 거기 있는지 모른 채 치워버리면 안 된다는 얘기죠.
여기서 6년차가 오히려 위험한 지점이 있어요. "예전 회사에선 이렇게 안 했는데"라는 기준이 강하게 박혀 있어서, 낯선 컨벤션을 성급하게 "틀렸다"고 판단하기 쉽습니다. 편견 리스크는 주니어보다 경력자가 더 클 수 있어요. 그래서 이 순서는 연차랑 상관이 없습니다. 3년차든 7년차든 낯선 코드 앞에선 똑같이 진입점부터 좁혀가야 하니까요.
특성화 테스트로 작은 첫 커밋 안전망 만들기
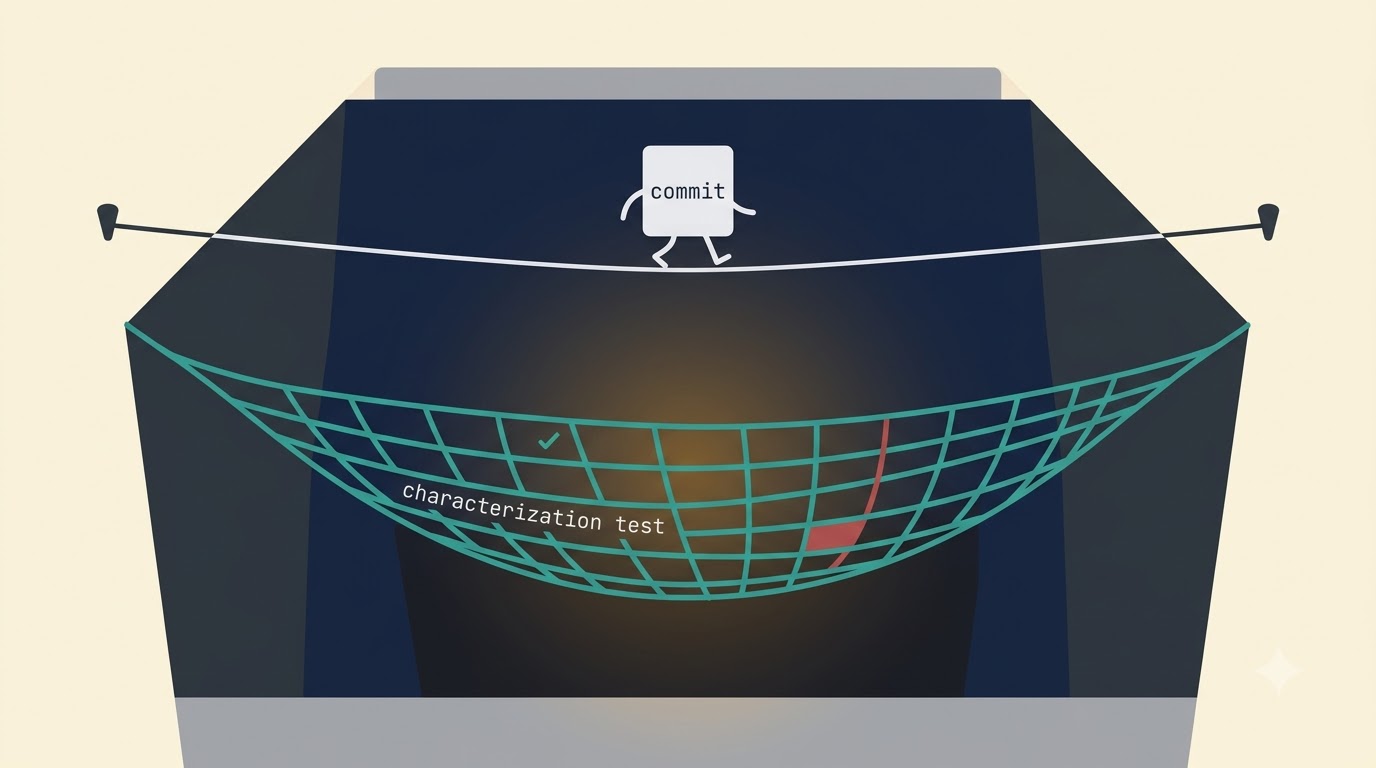
첫 목표는 완전한 이해가 아니라 안전망 확보라고 앞에서 말씀드렸는데요. 페더스의 특성화 테스트(Characterization Test)가 딱 그 도구입니다.
이건 코드가 올바른지를 검증하는 게 아니라, 지금 실제로 뭘 하는지를 고정하는 테스트예요. 순서는 이렇습니다.
- 이해하고 싶은 메서드를 하나 고릅니다.
- 일부러 틀릴 값으로 assert를 써서 테스트를 실행합니다.
- 실패 메시지에 찍힌 실제 반환값을 확인합니다.
- 그 실제 값으로 assert를 교체해 통과시킵니다.
이렇게 하면 테스트가 통과되는 동시에, 그 코드가 실제로 뭘 뱉는지 손으로 확인하며 배우게 됩니다. 읽기가 곧 학습 도구가 되는 셈이죠.
물론 한계도 있어요. 테스트 인프라가 아예 없거나 마감에 쫓기면 이런 과정이 사치처럼 느껴집니다. 그땐 작은 수정 → 관련 코드 검색 → 다시 수정, 이 짧은 루프를 여러 번 도는 걸로 대체하면 됩니다.
2026년이라 하나 덧붙이자면요. LLM한테 모듈 설명이나 흐름 요약을 시키면 몇 초 만에 나옵니다. 진짜 빨라졌어요. 근데 히스토리와 원래 의도를 검증하는 건 여전히 사람 몫입니다. 환각이 섞이거나 중요한 부분이 빠질 수 있어서요. 무시하면 시대착오, 맹신하면 위험이라는 균형점에 서 있는 셈이지요.
지도는 한 줄 바꿔보면서 그려집니다
낯선 레거시 코드 앞에서 전부 읽으려는 순간부터 시간은 새기 시작합니다. 진입점 목록으로 문을 찾고, 기능 하나를 세로로 관통해 데이터 흐름을 추적하고, 손으로 지도를 그리고, 작은 커밋으로 안전망을 확보하는 것. 이 순서가 반경을 좁혀줬어요.
6개월은 정상 구간에 가깝고, 헤맴은 실력이 아니라 정보 부재의 문제입니다.
몇 달 뒤 어느 날, 새로 온 팀원이 "이 기능 어디서 시작해요?" 하고 물었을 때 진입점 파일을 바로 짚어주는 자신을 보게 되실 거예요. 그 순간은 코드를 다 외워서 오는 게 아니라, 그동안 안전하게 바꿔본 한 줄 한 줄이 쌓여서 옵니다.
'Android 개발 > 트러블슈팅' 카테고리의 다른 글
| 안드로이드 StrictMode로 '가끔 뚝 끊김'을 매번 재현되는 위반으로 바꾼 일지 (0) | 2026.10.18 |
|---|---|
| DataStore 마이그레이션 실전기: 설정값 손실 없이 SharedPreferences 걷어낸 일지 (0) | 2026.10.13 |
| 에뮬레이터 3분 부팅을 90밀리초로: Robolectric로 JVM에서 UI 테스트 돌린 일지 (0) | 2026.10.09 |
| Android 17 QPR3 Beta 1, 고칠 코드는 0줄인데 왜 열어봐야 하나 (0) | 2026.10.06 |
| 안드로이드 메모리 누수, LeakCanary와 프로파일러로 20회 재현 실측 일지 (0) | 2026.10.05 |