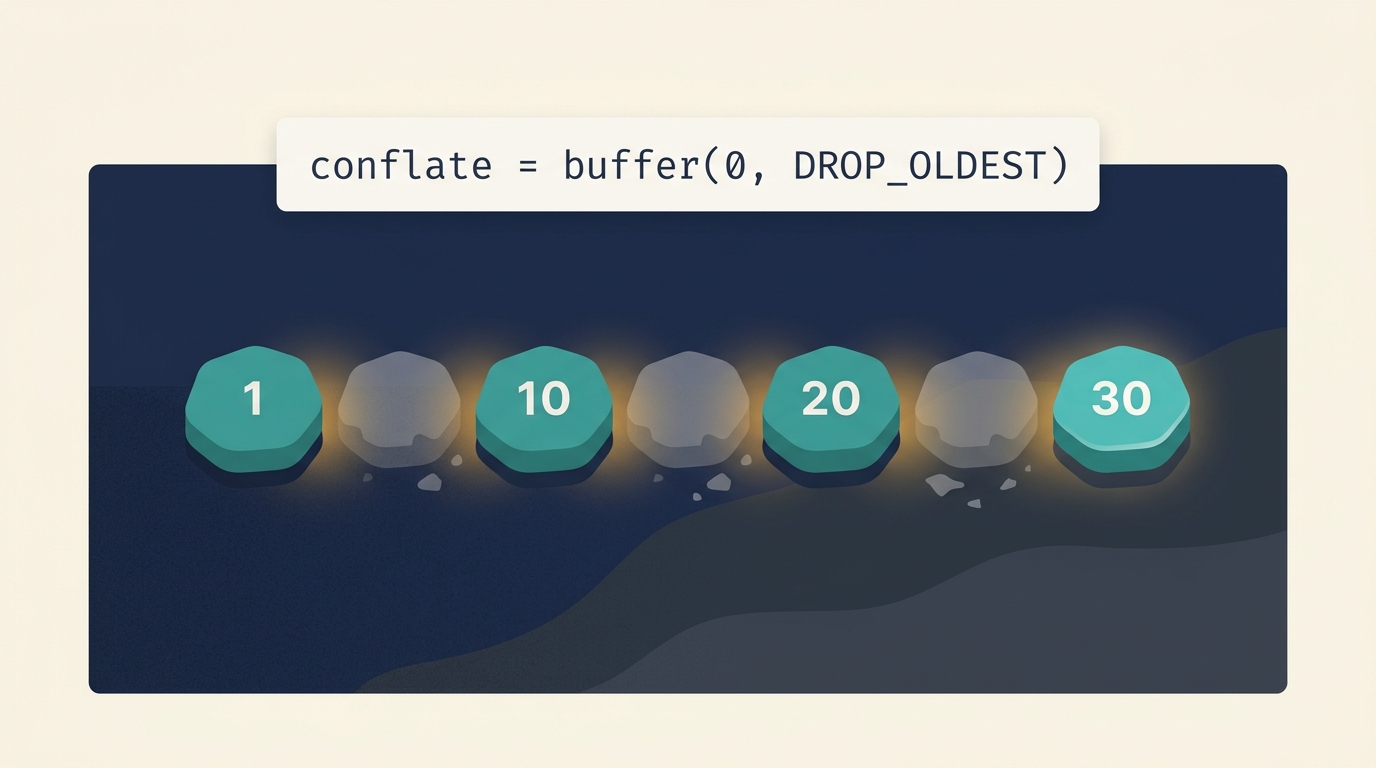
1~30을 100ms 간격으로 흘려보냈는데 처리에 30초가 걸렸어요. 근데 conflate 한 줄 붙이니까 1, 10, 20, 30만 남고 26개가 조용히 사라지더라고요.
그때 든 생각이 딱 하나였습니다. 이게 축복인지 재앙인지는 결국 제 화면이 정하는 거였구나. 진행률 바였으면 완벽한 해결이고, 결제 이벤트였으면 대형 사고였을 테니까요.
Kotlin Flow backpressure는 왜 파이프라인 전체를 느리게 만드나
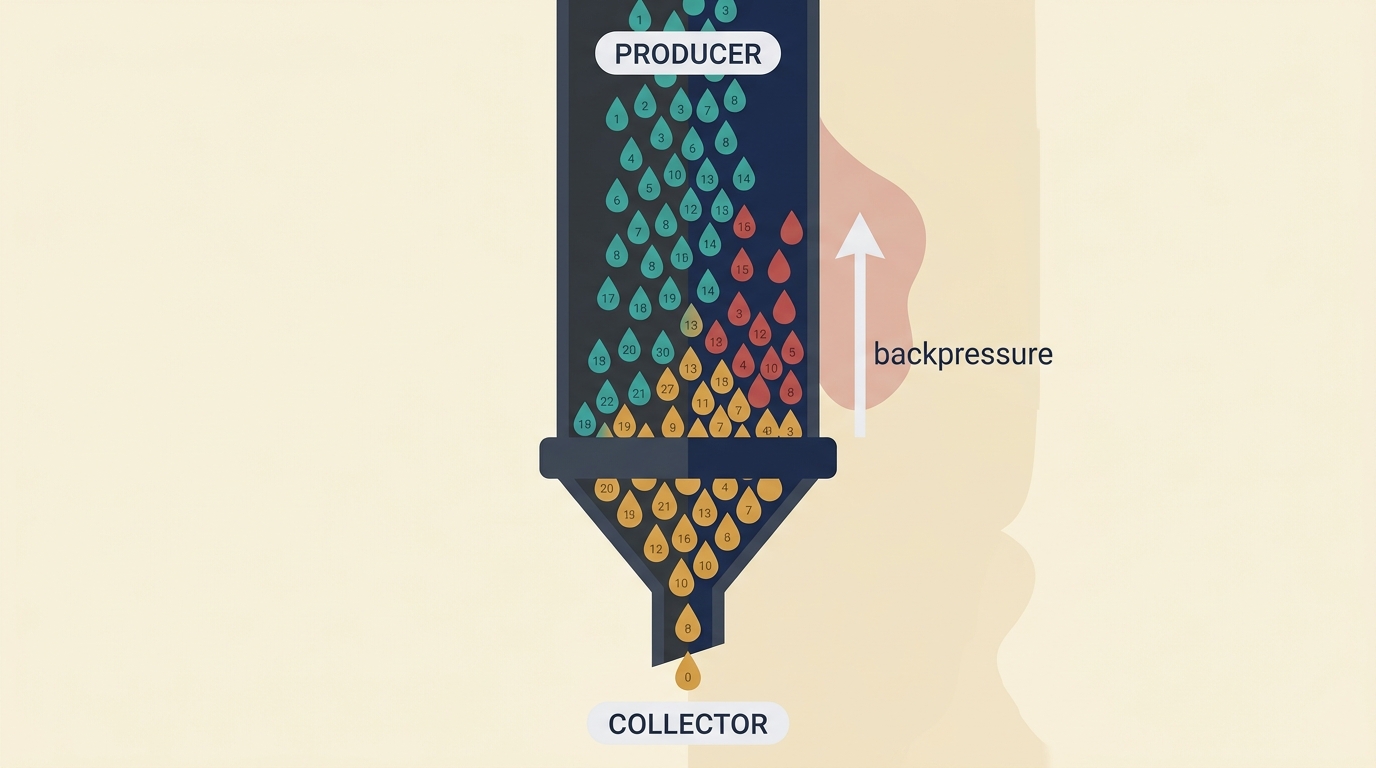
Kotlin Flow backpressure는 생산자가 소비자보다 빨리 값을 흘릴 때 터집니다. 근데 여기서 오해가 하나 생겨요. 느린 게 생산자 같지만, 진짜 범인은 대개 소비자라는 점입니다.
Flow는 기본이 순차 구조예요. 중간에 큐가 없거든요. 그래서 수집하는 쪽(collector)이 느리면 emit()이 suspend 되면서 그 지연이 생산자까지 거꾸로 올라옵니다.
공식 예시를 조금 확장한 형태인데, 이게 잘 보여줘요. 1~30을 100ms 간격으로 흘리고, 받는 쪽에서 원소마다 1초씩 delay를 걸면 총 30초쯤 걸립니다. 30초가 어느 정도냐면, 값 하나 흘려보내는 데 100ms면 충분한데 받는 쪽 때문에 300배 가까이 느려진 셈이지요. 이 30초가 앞으로 나올 비교의 기준선입니다.
buffer capacity 기본값과 코루틴 분리의 원리
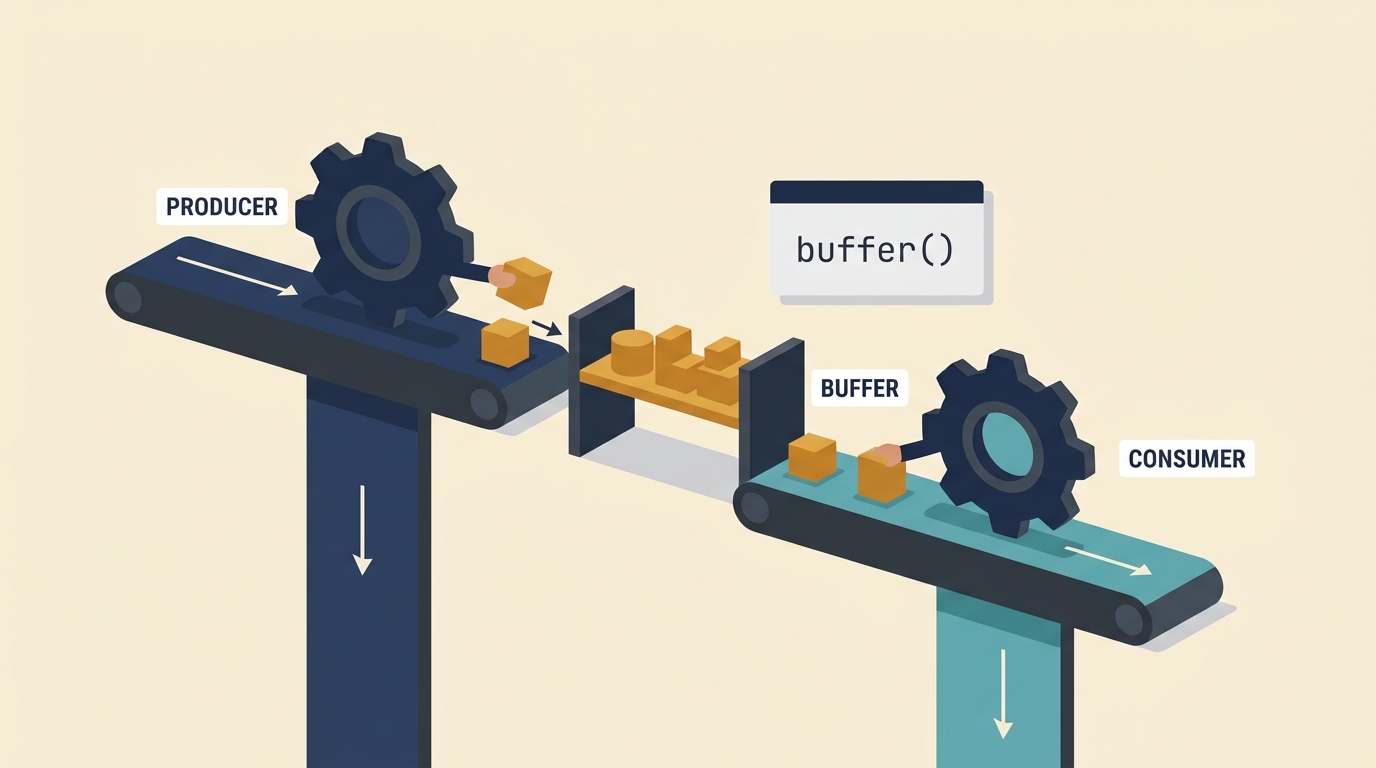
buffer()를 한 줄 붙이면 이 30초가 확 줄어듭니다. 근데 이게 "큐를 하나 달아줘서"가 아니에요. 핵심은 코루틴 분리, 그러니까 생산자와 소비자를 서로 다른 코루틴에서 병렬로 돌리는 데 있습니다.
flow {
    for (i in 1..30) {
        delay(100)
        emit(i)
    }
}
.buffer() // 생산자·소비자를 다른 코루틴으로 분리
.collect { value ->
    delay(1000) // 무거운 처리
    println(value)
}
기본 시그니처는 buffer(capacity = BUFFERED, onBufferOverflow = SUSPEND) 이렇게 됩니다. 기본 capacity는 64인데, 이건 시스템 프로퍼티로 바꿀 수 있어서 쓰기 전에 문서를 확인하시는 게 안전해요.
다만 주의하실 게 있어요. 기본이 SUSPEND라 값을 하나도 안 버리지만, 버퍼가 꽉 차면 결국 생산자가 다시 suspend 됩니다. 끝없이 값이 쏟아지는 무한 스트림에는 근본 해결이 아니라 증상 완화일 뿐이라는 얘기입니다.
Flow buffer conflate 차이, 중간값 26개는 어디서 사라지나
여기서 재밌는 게, conflate()는 사실 마법이 아니라 buffer의 특수한 경우예요. 정확히는 buffer(0, DROP_OLDEST)의 축약형입니다.
그러니까 buffer와 conflate는 별개의 도구가 아니라, 하나의 버퍼 설정 위에 놓인 두 지점이라고 보시면 됩니다. 이게 Flow buffer conflate 차이의 핵심이더라고요.
아까 30초짜리 예시에 conflate를 붙이면 받는 쪽은 대략 1, 10, 20, 30처럼 듬성듬성한 값만 봅니다. 나머지 값들은 소리 없이 사라져요. 받는 쪽이 하나 처리하는 동안 밀려든 값들 중 가장 최신 것만 남기고 중간을 다 버리는 방식입니다.
BufferOverflow는 세 종류예요.
- SUSPEND(기본): 공간 생길 때까지 생산자를 멈춰 세웁니다. 값 손실 없음.
- DROP_OLDEST: 오래된 값을 버리고 새 값을 받습니다. conflate 내부 동작이 이거예요.
- DROP_LATEST: 버퍼를 그대로 두고 새로 들어올 값을 버립니다.
진행률, 실시간 차트, 타이핑 입력처럼 최신값만 의미 있는 화면엔 conflate가 딱입니다. 근데 결제 이벤트나 로그 수집, 상태 머신처럼 중간값 하나하나가 다 살아있어야 하는 곳에선 이 손실이 되돌릴 수 없는 버그가 됩니다.
conflate vs collectLatest, 언제 무엇을 취소하나
여기서 collectLatest 차이를 짚고 가야 해요. 이름이 비슷해서 conflate랑 자주 헷갈리는데, 동작이 정반대입니다.
conflate는 지금 진행 중인 처리를 끝까지 완주시켜요. 그리고 그 다음에 최신값을 넘겨줍니다. 반면 collectLatest는 새 값이 오는 순간 진행 중이던 이전 블록을 즉시 취소하고 최신값으로 다시 시작합니다.
flow.collectLatest { query ->
    delay(300) // 입력 안정화 대기
    search(query) // 새 값 오면 이 작업이 취소됨
}
이 차이는 네트워크 요청이나 DB 조회처럼 무거운 처리에서 성능·정합성으로 크게 벌어져요. conflate는 이미 시작한 네트워크 호출을 다 마치고 다음으로 가지만, collectLatest는 그 호출을 중간에 끊고 리소스를 회수합니다.
검색 자동완성이 대표적이에요. 사용자가 "안드"까지 쳤을 때 날린 요청은, "안드로이드"까지 치는 순간 무의미해지거든요. 이럴 땐 완주보다 취소가 맞습니다. 다만 취소·예외 전파가 얽히면서 디버깅 난이도가 올라간다는 점은 감안하셔야 돼요.
실제 화면에서 backpressure 연산자 고르는 기준
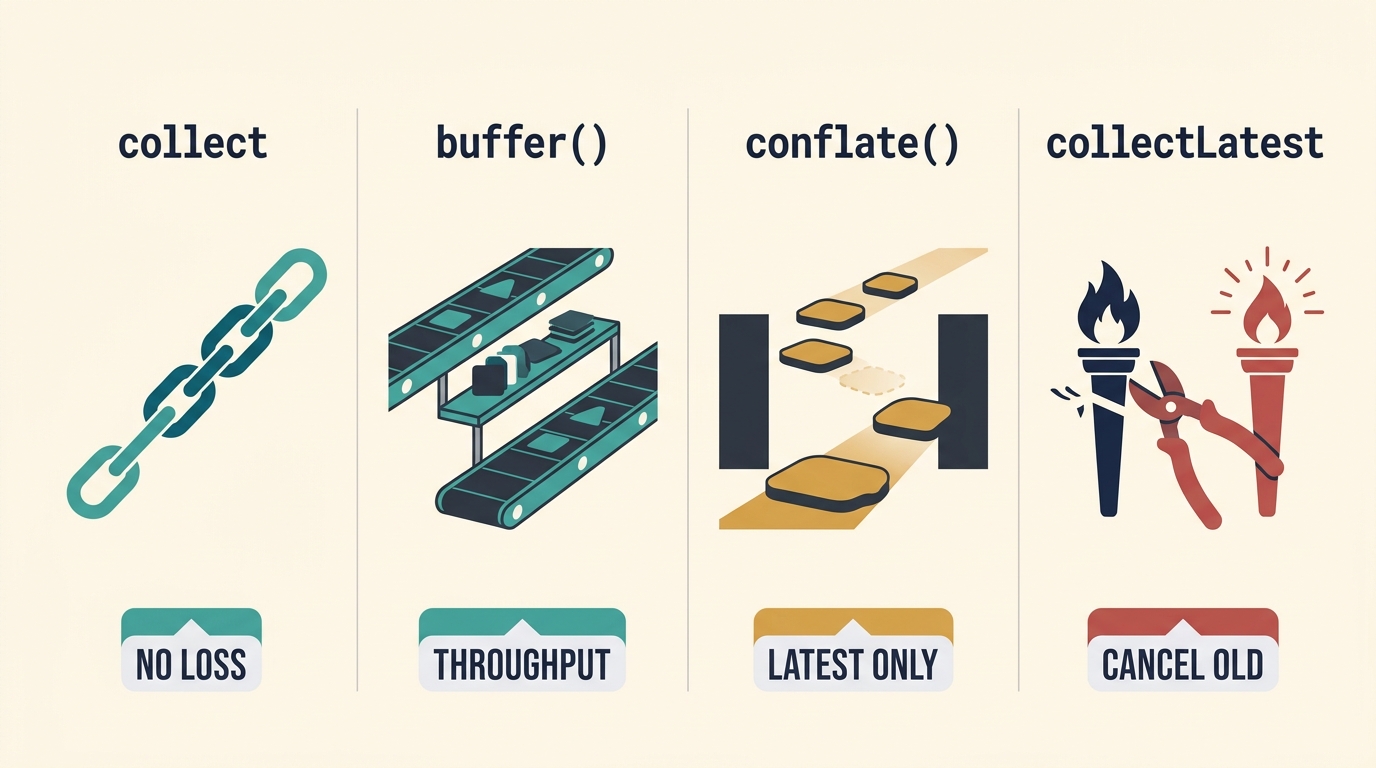
네 개를 다 알아도 못 고르겠다면, 저는 질문 하나로 정리하시길 권합니다. "이 값, 중간에 버려도 되나?"
- 손실 절대 불가(결제·로그) → 기본 collect 또는 buffer(SUSPEND)
- 최신값만 의미 있음(진행률·차트) → conflate
- 오래된 작업 자체를 폐기(검색) → collectLatest
저 같은 경우엔 실시간 진행률 바에는 conflate를, 로그 수집 파이프라인에는 buffer를 물려서 갔어요. 같은 backpressure 증상인데도 화면 성격이 다르면 정답이 뒤집히더라고요.
그리고 하나 더. 이 연산자들로 안 풀리는 무한 생산이라면, debounce(입력 안정화)나 sample(주기 샘플링), 아니면 소비자 병렬화·배치 같은 구조를 손보는 게 낫습니다. flowOn과 buffer 위치에 따라 여러 버퍼링이 하나로 합쳐지는(fusion) 엣지케이스도 보고돼 있어서(이슈 #4352), 세밀하게 튜닝할 땐 쓰는 버전 문서를 다시 확인하시는 게 안전해요.
정리하면 이렇습니다.
| 연산자 | 값 손실 | 생산자 suspend | 쓰는 자리 |
|---|---|---|---|
| 기본 collect | 없음 | 있음 | 순차·손실 불가 |
| buffer() | 없음 | 완화 | 모든 값 처리·처리량↑ |
| conflate() | 중간값 | 없음 | 진행률·차트 |
| collectLatest | 취소분 | 없음 | 오래된 작업 폐기 |
conflate 한 줄로 26개가 사라지던 그 화면 앞에서 제가 배운 건, backpressure 연산자 고르기가 성능 튜닝이 아니라 "무엇을 버릴 것인가"라는 도메인 결정이었다는 점입니다. 다음에 값이 밀리고 튀는 화면을 또 만나면, 아마 저는 빠른 CPU를 먼저 뒤지는 대신 코드 앞에서 잠깐 멈춰 이 값을 버려도 되는지부터 스스로에게 물어보고 있겠지요.
'Android 개발 > Kotlin' 카테고리의 다른 글
| Kotlin UUID, 2.4에서 java.util 없이 한 코드로 정리한 일지 (0) | 2026.10.04 |
|---|---|
| Hilt Koin 비교, 6년차가 프로젝트마다 갈라 쓰는 실전 기준 (0) | 2026.10.01 |
| 수식어 안 붙인 함수가 전부 public이었다: 코틀린 공개 API 경계 코드로 못 박은 일지 (0) | 2026.09.25 |
| Kotlin 컨텍스트 파라미터, 어느 값이 주입됐는지 눈에 보이게 만든 실전 일지 (0) | 2026.09.22 |
| Kotlin context parameters로 Logger·DB 인자 줄줄이 걷어낸 실전 일지 (0) | 2026.09.15 |