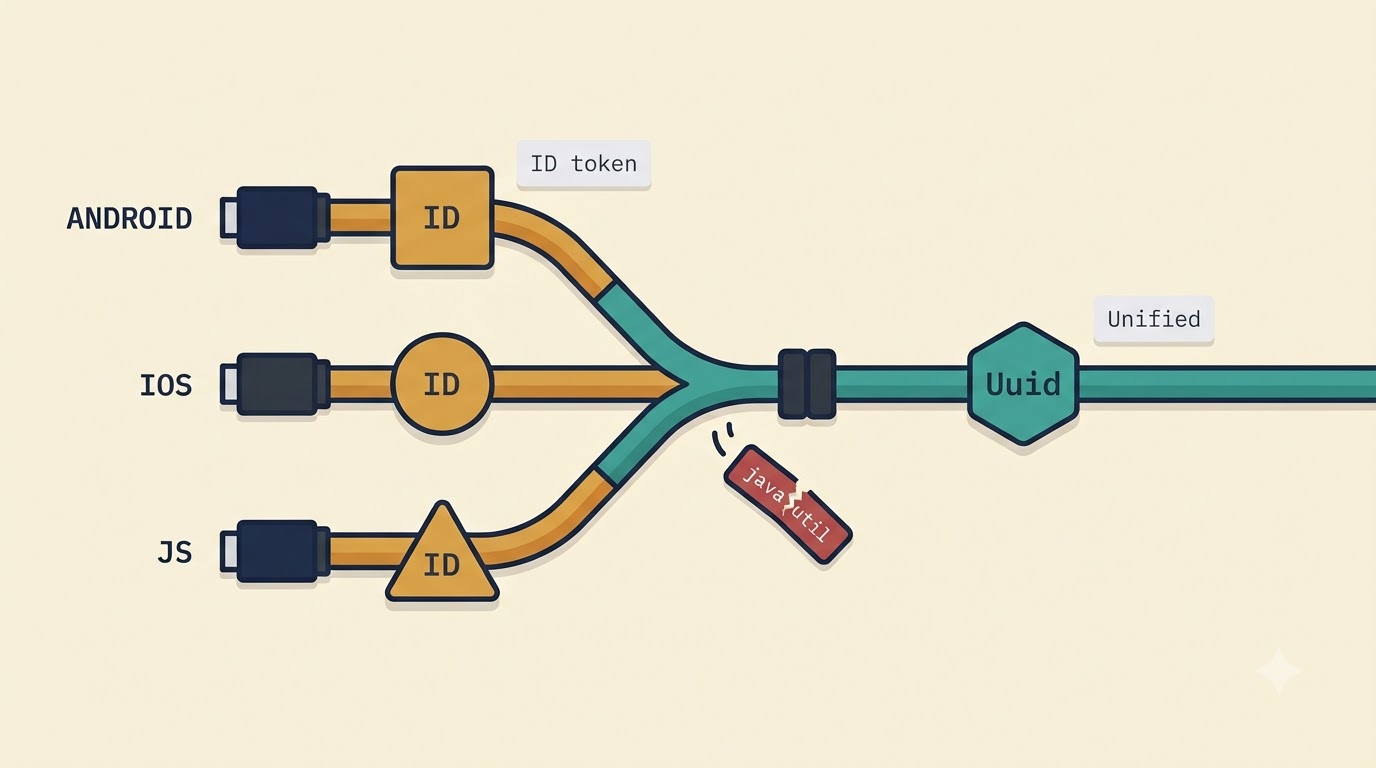
얼마 전에, 공유 모듈에 UUID.randomUUID() 한 줄 넣고 빌드를 돌렸더니 iOS랑 JS 타깃이 컴파일부터 막히더라고요. UUID 하나 뽑겠다고 expect/actual을 세 벌씩 쓰고 있었습니다.
java.util은 JVM 전용이라 공유 코드에서 부르면 안 되는 게 당연한데, 막상 대안이 없으니 손이 자꾸 그리로 가요. 이번에 코틀린(Kotlin) 2.4로 올리면서 이 지저분한 자리를 한 번 정리했는데요. 마이그레이션 코드가 얼마나 줄었는지, 그리고 정리하다 마주친 노란 경고의 정체까지 순서대로 풀어볼게요.
expect/actual로 갈라지던 KMP UUID 생성
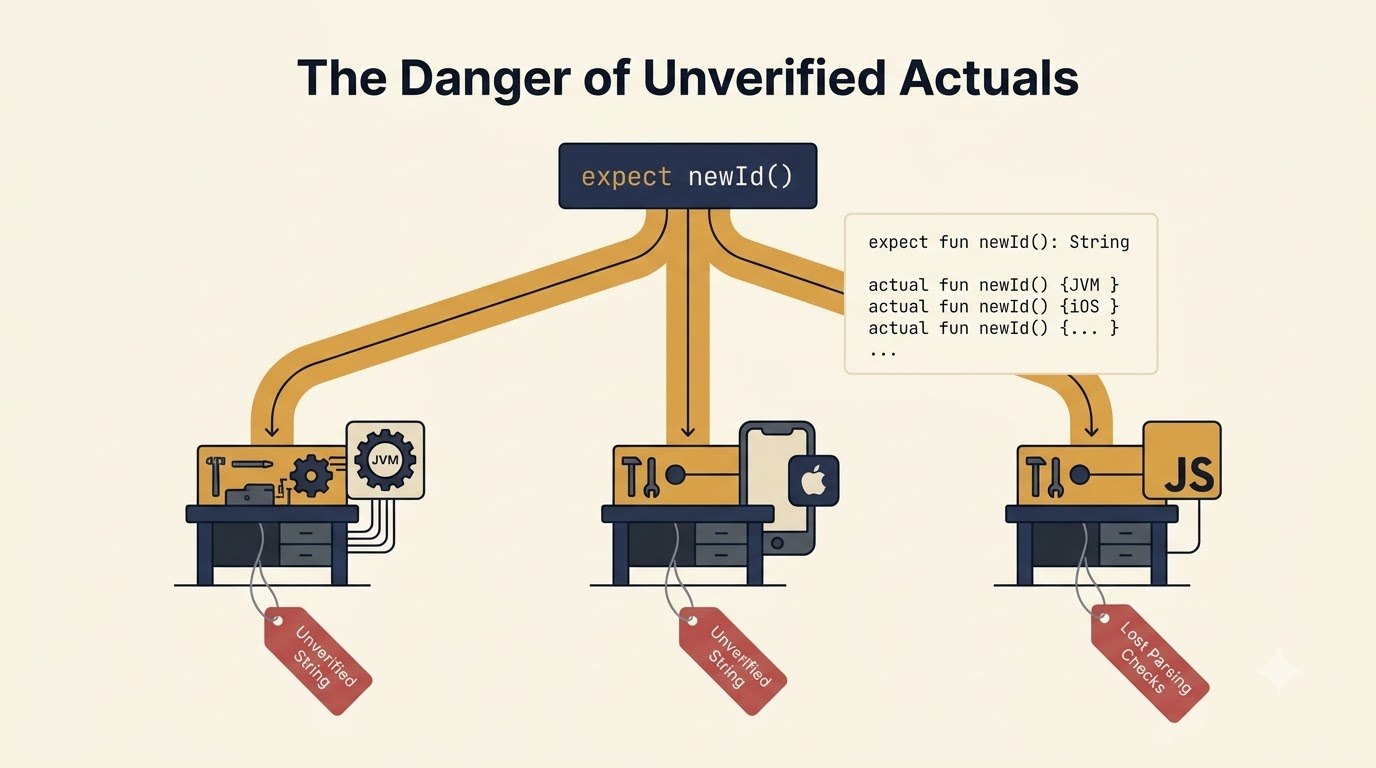
멀티플랫폼 프로젝트에서 ID 하나 만드는 게 왜 이렇게 번거로웠냐면요. 공유 코드엔 java.util.UUID를 못 쓰니까 이런 식으로 갈랐습니다.
// commonMain
expect fun newId(): String

// androidMain / jvmMain
actual fun newId(): String = java.util.UUID.randomUUID().toString()

// iosMain
actual fun newId(): String = NSUUID().UUIDString
플랫폼마다 반환 타입도 제각각이라, 결국 ID 필드를 그냥 String으로 눕혀놓고 쓰는 우회책을 많이 택했어요. 근데 문자열로 눕혀두면 파싱 검증이 빠져서, 엉뚱한 값이 들어와도 런타임 전까진 모르는 부작용이 생기더라고요.
kotlin.uuid.Uuid 타입 자체는 2.0.20(2024)에 실험용으로 처음 들어왔었어요. 그러다 Kotlin 2.4.0(2026년 6월)에서 이 타입이 Stable로 승격되면서, 드디어 안드로이드·백엔드·iOS·JS가 같이 쓸 수 있는 공통 UUID 타입이 생겼습니다. expect/actual 세 벌이 한 줄로 줄어든 거죠.
코틀린 표준 UUID API 사용법과 남은 opt-in 경고
기본 쓰임새는 이렇게 간단합니다.
import kotlin.uuid.Uuid
import kotlin.uuid.ExperimentalUuidApi

@OptIn(ExperimentalUuidApi::class)
fun demo() {
    val id: Uuid = Uuid.random()                                  // v4 랜덤
    val parsed: Uuid = Uuid.parse("3f2dd185-...")                 // 대시 포맷 파싱
    val safe: Uuid? = runCatching { Uuid.parse("깨진값") }.getOrNull()  // 실패 시 null
}
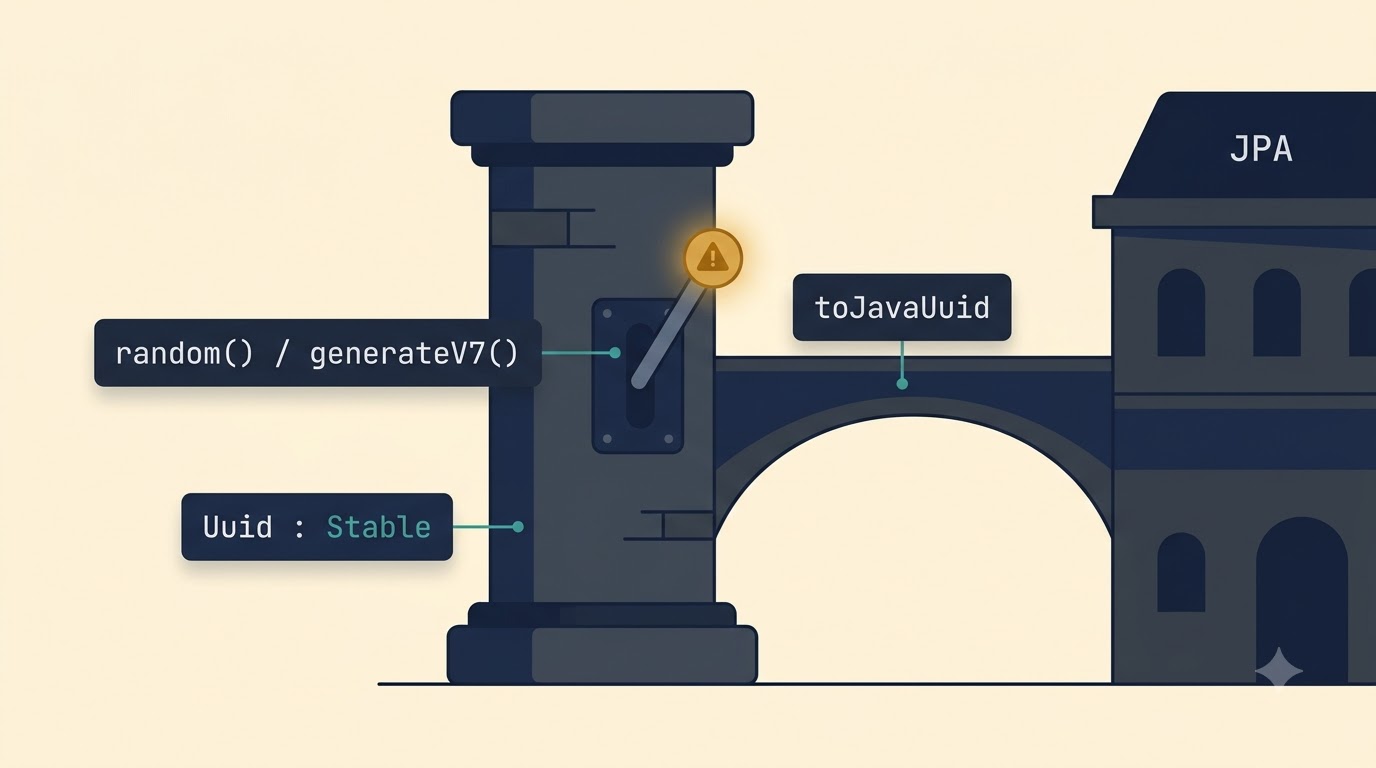
여기서 좀 헷갈리는 반전이 하나 있어요. 타입 Uuid는 Stable인데, 정작 매일 부르는 Uuid.random()이랑 뒤에 나올 generateV7()은 여전히 실험 단계로 남아 있습니다. 그래서 @OptIn(ExperimentalUuidApi::class)를 안 붙이면 IDE에 노란 경고가 떠요. "Stable됐다며?" 싶은데 생성 함수만 따로 노는 상황인 거죠.
실패 시 null을 돌려받고 싶으면 runCatching { Uuid.parse(...) }.getOrNull()로 감싸면 되는데요. 예외 던지고 try-catch로 받던 것보다 간결해서 저는 이쪽을 더 자주 씁니다.
다만 실험 API를 프로덕션에서 아예 금지하는 팀이라면, 이 opt-in 하나가 도입 걸림돌이 될 수 있어요. 그런 팀은 타입만 통일하고 생성은 기존 방식을 유지하는 절충도 방법이라고 봅니다.
toJavaUuid로 레거시 경계만 변환하는 하이브리드
"그럼 이제 java.util.UUID 다 버리면 되겠네" 싶겠지만, 현실은 그렇게 깔끔하지 않아요. 스프링 데이터(Spring Data)·JPA·하이버네이트(Hibernate)·JDBC·잭슨(Jackson) 전부 아직 java.util.UUID 기준으로 돌아가거든요. 다 버리라는 건 비현실적인 얘기입니다.
그래서 제가 잡은 방식은 하이브리드예요. 도메인 내부는 Uuid로 쓰고, DB에 저장하거나 라이브러리에 넘기는 경계에서만 변환합니다.
@OptIn(ExperimentalUuidApi::class)
fun boundary() {
    val id: Uuid = Uuid.random()
    val forJpa = id.toJavaUuid()                          // Kotlin → Java
    val back = java.util.UUID.randomUUID().toKotlinUuid() // Java → Kotlin
}
이 toJavaUuid() / toKotlinUuid() 변환 함수는 2.4부터 안정 트랙에 올라서, 생성 함수와 달리 opt-in 없이 써도 됩니다.
물론 순수 멀티플랫폼 프로젝트가 아니라면, 경계마다 변환 코드가 붙어서 오히려 라인이 늘어나는 맞바꿈이 생겨요. JVM 백엔드만 쓰는데 실익이 있냐고 물으면, 솔직히 반감된다고 봐요. 이 부분은 프로젝트 성격 보고 판단하시는 게 좋겠습니다.
generateV7로 정렬 가능한 UUID, DB 인덱스 단편화 완화
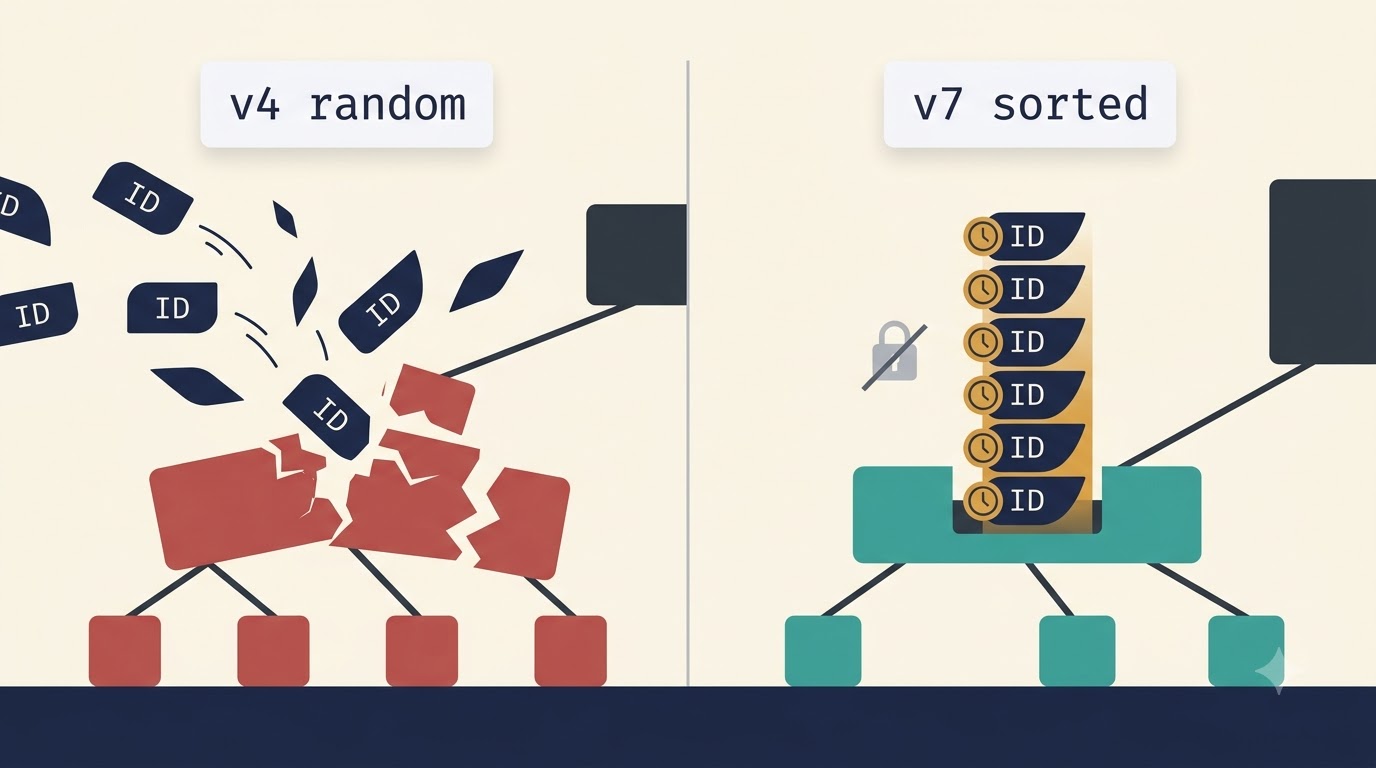
랜덤 v4 UUID를 그대로 PK로 박으면, 값이 사방팔방 흩어져서 B-tree 인덱스가 산산조각 납니다. 이걸 Uuid.generateV7()로 바꾸면, UNIX 밀리초 타임스탬프를 앞에 깔고 뒤에 랜덤을 붙여 단조 증가하는 값이 나와요. 생성 순서대로 정렬되니까 인덱스가 훨씬 얌전해집니다.
여기서 성능 오해 하나만 짚고 갈게요. "코틀린 UUID가 더 빠르다"는 말이 도는데, 근거가 좀 애매합니다. Uuid 타입 자체가 빠른 게 아니라, 이득은 랜덤 소스랑 v7에서 오는 거예요.
원래 자바의 UUID.randomUUID()는 단일 SecureRandom에서 16바이트씩 읽느라 동기화 병목이 생기는데요. 이게 서버 CPU를 1%가량 갉아먹은 사례가 OpenJDK 이슈(JDK-8308804)로 보고돼 있습니다. 한 UUIDv7 최적화 사례에서는 981ns가 82ns로, 12배 빨라졌다는 기록도 있어요(John Gray의 Medium 글 'From 981ns to 82ns: A UUIDv7 Optimization Story'). 픽셀 10 프로에서 Jetpack Microbenchmark로 잰 값이고, 비교 대상은 안드로이드 네이티브 UUID 구현이었어요. 981ns가 감이 안 오신다면, 눈 깜빡할 시간에 백만 개를 뽑느냐 천이백만 개를 뽑느냐 차이라고 보시면 됩니다. 다만 이런 수치는 특정 환경 결과라, 본인 서버에서 직접 재보는 게 맞습니다.
그리고 v7엔 맞바꿈이 있어요. 타임스탬프가 앞에 깔리니까 생성 시각이 유추됩니다. RFC 9562도 UUID는 유일성이 목적이지 암호학적 난수를 강제하진 않는다고 명시하고 있어요. 그러니까 정렬성이 필요한 PK엔 v7이 좋지만, 추측하기 어려워야 하는 보안 토큰엔 v7을 쓰면 안 됩니다. 정렬성과 프라이버시는 여기서 정반대로 갈립니다.
결국 이번 작업의 진짜 이득은 속도가 아니라, 흩어져 있던 UUID 생성이 하나의 타입으로 모인다는 점입니다. 타입은 Uuid로 통일하되 생성 함수엔 opt-in을 꼭 확인하고, 레거시 라이브러리는 경계에서만 변환하고, DB PK엔 v7을 쓰되 보안 토큰엔 손대지 않는 것. 이 네 갈래만 눈 뜨고 챙기면, 저처럼 java.util에 손 뻗다 빌드가 갈라지는 일은 다시 안 겪으실 거예요.
'Android 개발 > Kotlin' 카테고리의 다른 글
| runCatching이 코루틴 취소까지 삼킨 날, 코틀린 에러 처리를 다시 짰습니다 (0) | 2026.10.15 |
|---|---|
| Kotlin 2.4 구조분해로 필드 순서 버그를 코드에서 지운 기록 (0) | 2026.10.07 |
| Hilt Koin 비교, 6년차가 프로젝트마다 갈라 쓰는 실전 기준 (0) | 2026.10.01 |
| 값이 밀리고 튀던 Flow, buffer와 conflate가 각각 살린 것 (0) | 2026.09.29 |
| 수식어 안 붙인 함수가 전부 public이었다: 코틀린 공개 API 경계 코드로 못 박은 일지 (0) | 2026.09.25 |