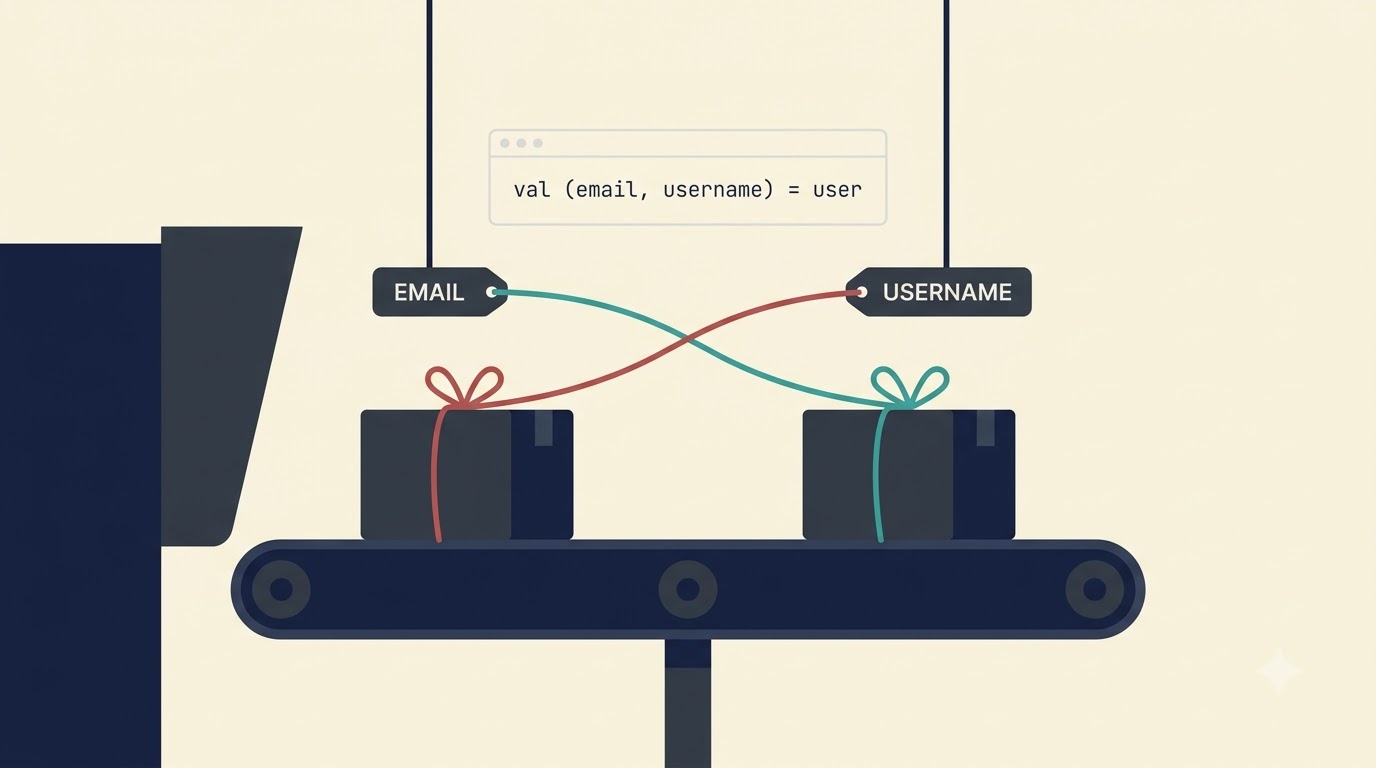
테스트도 초록불, 빌드도 초록불인데 가입 확인 메일이 엉뚱한 주소로 날아간 적 있으신가요? 범인은 val (email, username) = user 딱 한 줄이었습니다. 코틀린 2.4(Kotlin 2.4) 이름 기반 구조분해로 이 사고를 원천 차단한 일지를 풀어볼게요.
작년에 사이드 프로젝트로 돌리던 회원 서비스에서 실제로 겪은 일입니다. 코드 리뷰도 통과했고 단위 테스트도 다 통과했는데, 어느 순간부터 가입 메일이 사용자 이름 문자열을 주소로 잘못 물고 나가더라고요. 처음엔 메일 라이브러리를 의심했는데, 진짜 범인은 구조분해 한 줄이었습니다.
위치 기반 구조분해가 값을 조용히 바꿔치기한 순간
코틀린의 data class는 주 생성자에 선언한 프로퍼티 순서대로 component1(), component2()를 자동으로 만들어줍니다. 그리고 val (a, b) = user는 변수 이름을 전혀 안 보고 위치로만 값을 꺼내옵니다.
data class User(val email: String, val username: String)

val user = User("a@test.com", "dodo")
val (email, username) = user   // component1 → email, component2 → username
여기까진 멀쩡해요. 문제는 나중에 누군가 프로퍼티를 알파벳순으로 정리하면서 시작됩니다.
// 필드 순서만 바꾼 리팩터링 커밋
data class User(val username: String, val email: String)

// 이 줄은 아무도 안 건드렸는데
val (email, username) = user
// 이제 email 변수엔 username 값이, username 변수엔 email 값이 들어옵니다
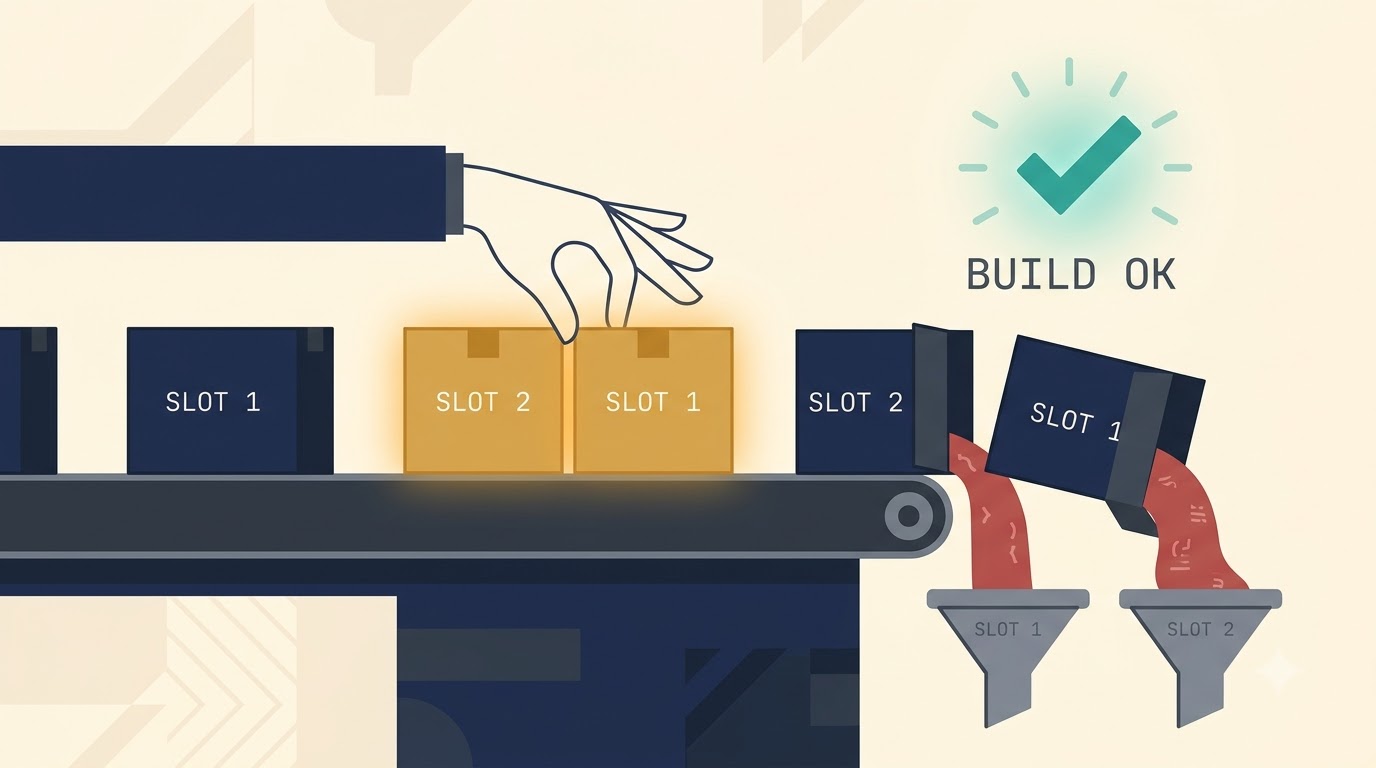
username도 String, email도 String이라 컴파일러가 못 잡습니다. 타입이 같으니 빌드는 초록불 그대로 프로덕션까지 직행하는 거예요. "코틀린은 타입 안전하니까 괜찮겠지" 하는 믿음이 위치 기반 구조분해 앞에서는 통하지 않더라고요.
제가 겪은 게 딱 이 시나리오였습니다. 구조분해 라인은 손도 안 댔는데 값이 뒤집힌, 말 그대로 유령 버그였습니다.
Kotlin 2.4 이름 기반 구조분해 문법 살펴보기
이걸 언어 차원에서 손봐준 게 이름 기반 구조분해(name-based destructuring)입니다. 코틀린 2.4.0이 2026년 6월 3일 정식 릴리스됐고, 이번 버전의 대표 기능으로 소개됐어요. 처음 실험적으로 들어온 건 2.3.20이었고, 2.4에서 전면에 부각된 흐름입니다.
핵심은 변수 이름으로 값을 꺼낸다는 점이에요. 명시형 문법이 이렇게 생겼습니다.
// 프로퍼티 이름(email, username)으로 매칭 → 순서 뒤바뀌어도 안전
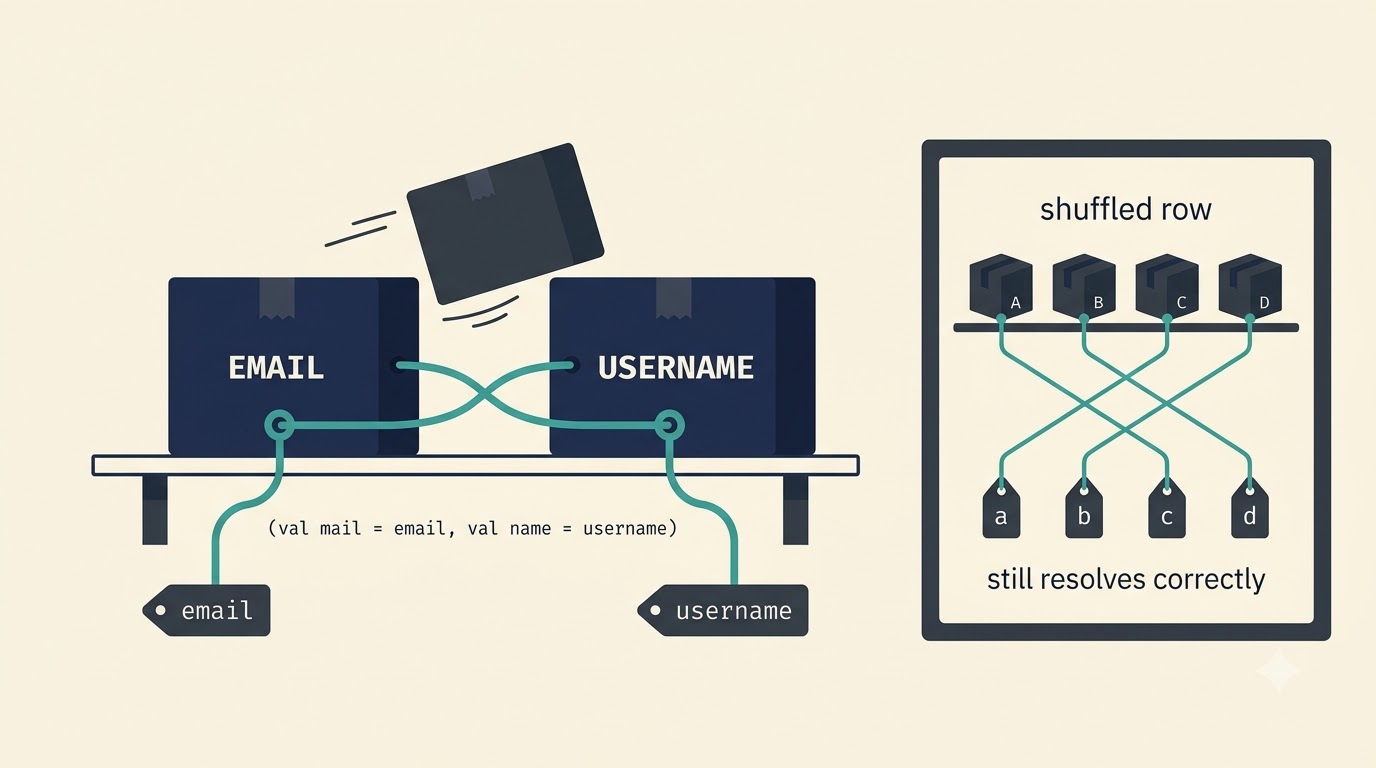
(val mail = email, val name = username) = user
이제 data class 안에서 필드 순서를 아무리 바꿔도 email은 email끼리, username은 username끼리 붙습니다. 위치가 아니라 이름이 기준이니까요.
다만 이 문법은 아직 실험적 단계라 컴파일러 인자 -Xname-based-destructuring을 켜야 동작하는 것으로 알려져 있어요. 축약형이나 세부 표기는 버전에 따라 달라질 수 있으니, 실제 적용 전에 공식 릴리스 노트와 KEEP 문서를 한 번 확인하시는 게 정확합니다.
사실 자바스크립트 ES6나 타입스크립트(TypeScript) 쓰던 분들은 const { email, name } = user 처럼 10년 전부터 이름 기반이 기본이었습니다. 코틀린이 2026년에야 뒤늦게 따라온 셈이지요.
구조분해 대괄호 문법과 위치 기반이 남는 자리
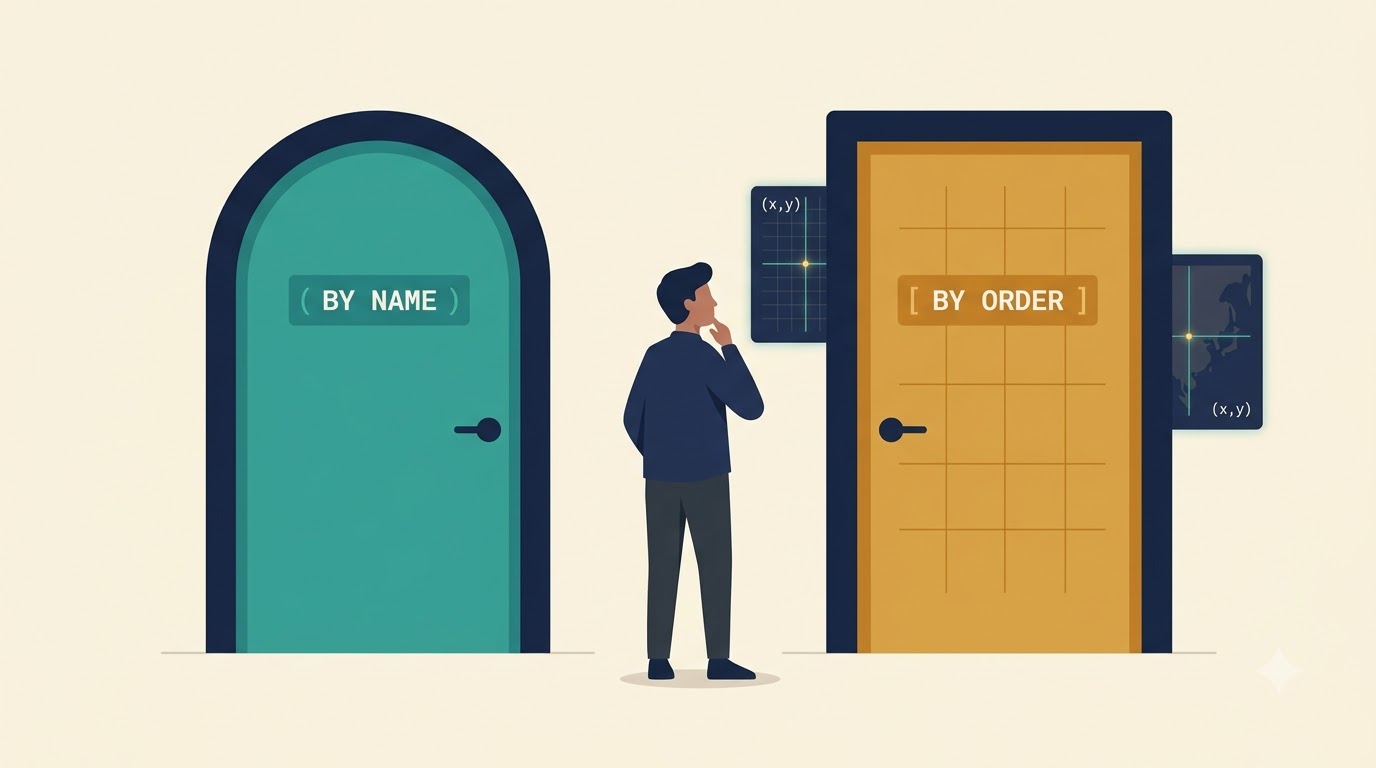
그럼 위치 기반은 완전히 사라지느냐, 그건 아닙니다. 좌표 (x, y)처럼 순서 자체가 의미인 경우도 있으니까요. 이럴 때 쓰라고 대괄호 문법이 따로 남습니다.
// 위치가 곧 의미인 경우엔 대괄호로 명시
[val number, val string] = pair
이 대괄호 문법의 존재를 아는 분이 아직 드문 것 같아요. 전환기에는 소괄호 이름 기반과 대괄호 위치 기반이 공존하니까 이 구분을 알아두시면 좋겠습니다.
한 가지 더 주의하실 게, for ((k, v) in map) 같은 반복문 구조분해도 관습상 안전해 보이지만 똑같은 위치 기반입니다. 그리고 로드맵상 향후 버전에서 소괄호 ()가 점진적으로 이름 기반으로 전환될 예정이라고 하니, "변수명과 프로퍼티명이 우연히 다른" 기존 코드는 동작이 바뀔 여지가 있습니다. 큰 코드베이스라면 그 전환 시점이 오기 전에 점검이 필요해 보여요.
참고로 인텔리J(IntelliJ)는 예전부터 변수명이 프로퍼티명과 다르면 노란 밑줄로 경고를 줬는데, 많은 팀이 그냥 무시했다고 합니다. 그 무시가 쌓여서 언어 차원 해결까지 온 거예요.
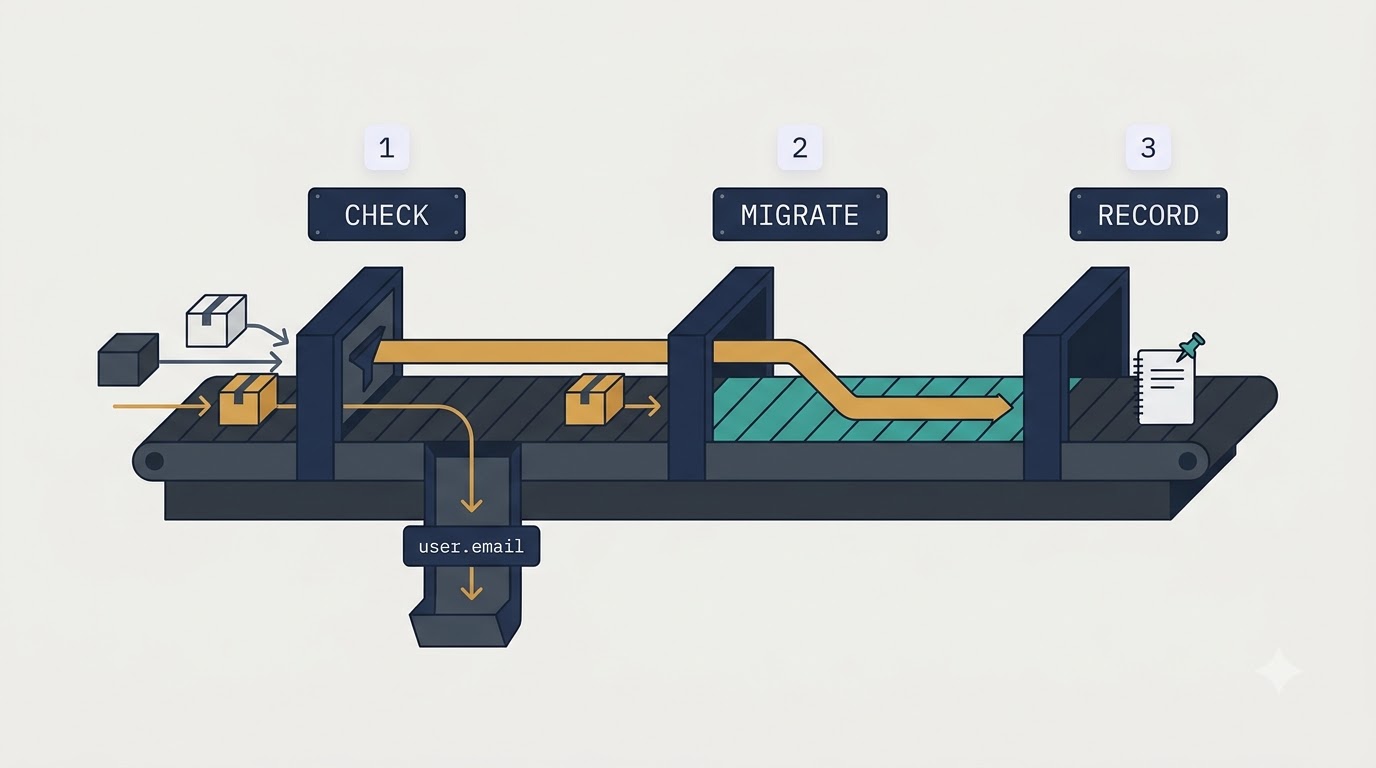
data class 구조분해를 안전하게 옮긴 순서
제가 실제로 옮길 때 밟은 순서를 정리해봤어요.
1. 구조분해가 꼭 필요한 자리인지부터 판단
필드가 3개 이상이거나 타입이 겹치면, 이름 기반으로 바꾸기 전에 user.email처럼 명시 접근으로 되돌릴지부터 봤습니다. 구조분해가 꼭 필요한 자리가 아니면 안 쓰는 게 제일 안전하더라고요.
2. 고위험 라인부터 이름 기반으로 이관
타입이 같으면서 사용자 데이터를 다루는 라인부터 이름 기반 명시형으로 우선 옮겼습니다. 플래그가 실험적이라 전면 도입은 아직 시기상조라, 사고 위험이 큰 곳만 선별했어요.
3. 근본 원인은 따로 기록
옮기고 나서도 근본 원인은 남는다는 걸 메모해뒀습니다. data class에 componentN을 무조건 자동 생성한 초기 설계가 뿌리인데, 이름 기반은 증상을 완화할 뿐 Pair나 Triple 남발하는 습관까지 바꿔주진 않으니까요.
개인적으로는 고위험 라인만 이름 기반으로 바꾸고, 나머지는 아예 user.email 명시 접근으로 풀어버리는 쪽을 추천합니다. 이유는 간단해요. 필드 두세 개짜리를 굳이 구조분해로 압축해서 얻는 이득보다, 순서 사고로 잃는 디버깅 시간이 훨씬 크다고 보거든요.
위치 기반 구조분해는 "코틀린은 타입 안전하다"는 믿음이 통하지 않는 사각지대였습니다. 이름 기반은 그 순서 사고를 런타임에서 컴파일 이전으로 끌어올려 준다는 게 제일 큰 의미고요.
변수 이름이 그냥 장식이던 시대는 끝나가는 중입니다. 다음 리팩터링에서 data class 필드 순서를 정리하다가 손이 멈칫하는 순간이 온다면, 그건 이름 기반으로 옮길 자리를 코드가 알려주는 신호입니다.
'Android 개발 > Kotlin' 카테고리의 다른 글
| runCatching이 코루틴 취소까지 삼킨 날, 코틀린 에러 처리를 다시 짰습니다 (0) | 2026.10.15 |
|---|---|
| Kotlin UUID, 2.4에서 java.util 없이 한 코드로 정리한 일지 (0) | 2026.10.04 |
| Hilt Koin 비교, 6년차가 프로젝트마다 갈라 쓰는 실전 기준 (0) | 2026.10.01 |
| 값이 밀리고 튀던 Flow, buffer와 conflate가 각각 살린 것 (0) | 2026.09.29 |
| 수식어 안 붙인 함수가 전부 public이었다: 코틀린 공개 API 경계 코드로 못 박은 일지 (0) | 2026.09.25 |